در گذشته، توسعه پروژههای یادگیری ماشین به کدنویسی دستی الگوریتمهای پیچیده ریاضی و فرمولهای آماری نیاز داشت. این کار زمان زیادی میگرفت و احتمال خطا را افزایش میداد. با گسترش کتابخانههای آماده، برنامهنویسان توانستند بدون درگیر شدن با جزئیات محاسبات پایه، مستقیماً بر طراحی و آموزش مدلهای هوش مصنوعی تمرکز کنند.
تنسورفلو (TensorFlow) بهعنوان یکی از فریمورکهای اصلی برای ساخت مدلهای یادگیری عمیق و شبکههای عصبی شناخته میشود. از آنجا که نسخه اصلی این کتابخانه بر پایه زبان پایتون توسعه یافته است، گذراندن دورههای آموزش پایتون و آشنایی با ساختارهای پایه این زبان، پیشنیاز اصلی ورود به این حوزه و کار با تنسورفلو است. در این مقاله، معماری کتابخانه، ابزارهای مکمل آن مانند TensorBoard، روش نصب و مراحل ساخت یک مدل شبکه عصبی را بررسی میکنیم.
کتابخانه TensorFlow چیست؟
تنسورفلو (TensorFlow) کتابخانهای رایگان و متنباز برای برنامهنویسی جریان داده (Dataflow Programming)، برنامهنویسی متمایزگر (Differentiable Programming) و ریاضیات نمادین است. این فریمورک ابزارهای لازم برای محاسبات عددی، مباحث آموزش جبر خطی، تعریف تابعهای خطا و بهینهسازها و پیادهسازی شبکههای عصبی را در پروژههای یادگیری ماشین و آموزش یادگیری عمیق فراهم میکند.
تیم «گوگل برین» (Google Brain) ابتدا این کتابخانه را برای مصارف داخلی، پژوهشهای یادگیری ماشین و توسعه شبکههای عصبی عمیق در شرکت گوگل ساخت. تنسورفلو در ۹ نوامبر ۲۰۱۵ با مجوز متنباز آپاچی ۲.۰ (Apache ۲.۰) منتشر شد. نام TensorFlow از روش پردازش دادهها در آن گرفته شده است: شبکههای عصبی روی آرایههای داده چندبعدی، یعنی تانسورها، عملیات انجام میدهند و این تانسورها در ساختار مدل جریان مییابند (Flow).
معماری TensorFlow چگونه کار میکند؟
تنسورفلو بر دو جزء متکی است: ساختار داده پایه به نام «تانسور» (Tensor) و موتور اجرایی که محاسبات ریاضی را مدیریت میکند. در این فریمورک، تمام ورودیها و خروجیها در قالب آرایههای چندبعدی تانسور تعریف میشوند. الگوریتمهای آموزش یادگیری ماشین نیز بهصورت شبکهای از عملیات بههمپیوسته روی همین دادهها پردازش میشوند.
موتور اجرایی تنسورفلو پردازشها را به دو روش انجام میدهد. روش اول، ساخت «گراف محاسباتی» (Computational Graph) است که جریان داده و توالی عملیات را تعریف میکند. روش دوم، حالت «اجرای مشتاقانه» (Eager Execution) است که دستورات را بلافاصله ارزیابی میکند. این ساختار انعطافپذیر اجازه میدهد کدها بدون بازنویسی روی پردازندههای مختلف (CPU، GPU و TPU) اجرا شوند؛ چه روی کامپیوترهای شخصی و چه روی سرورها و دستگاههای موبایل. هر یک از این بخشها را بررسی میکنیم.
مفهوم تانسور (Tensor) و ابعاد داده
تانسور (Tensor) واحد بنیادی داده در تنسورفلو است. در ریاضیات و فیزیک، تانسور مفهومی هندسی برای گسترش اعداد اسکالر (کمیتهای نردهای)، بردارها و ماتریسها به ابعاد بالاتر است. در یادگیری ماشین، این واژه به ساختار داده یا آرایهای چندبعدی اشاره دارد که میتواند حجم بالایی از دادههای عددی را ذخیره کند، مشابه نقش ساختار ماتریس در متلب.
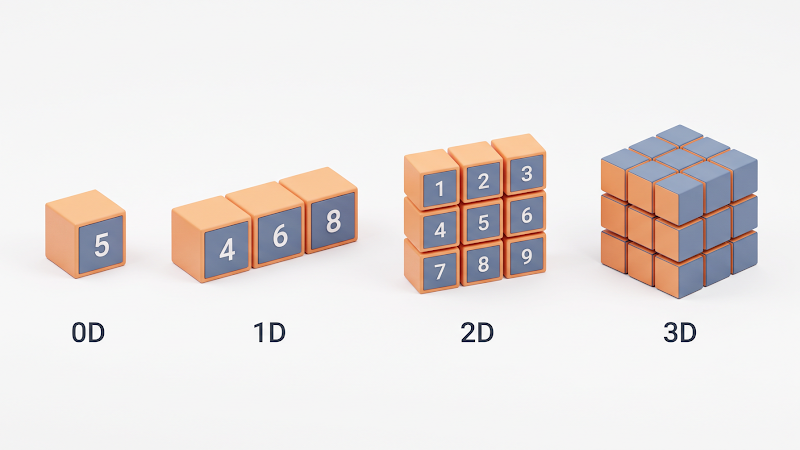
هر تانسور سه ویژگی اصلی دارد:
- dtype (نوع داده): نوع مقادیر ذخیرهشده در تانسور را مشخص میکند. این نوع میتواند float32 (حالت پیشفرض)، int32، bool، string یا complex64 باشد.
- rank (مرتبه یا تعداد ابعاد): تعداد ابعاد تانسور را نشان میدهد. در یادگیری ماشین، گاهی واژه «بعد» (Dimension) به جای rank به کار میرود.
- shape (شکل یا اندازه هر بعد): تعداد عناصر هر بعد را مشخص میکند. برای مثال، تانسوری با شکل [۱۰, ۵] یک تانسور ۲بعدی، یا با مرتبه ۲، است که اندازه بعد اول آن ۱۰ است.
شناخت ساختار آرایهها و کار با کتابخانههایی مانند NumPy، یکی از پیشنیازهای اصلی آموزش برنامه نویسی پایتون برای ورود به حوزه علم داده است. برای روشن شدن مفهوم ابعاد تانسور، فرض کنید میخواهیم نمرات درسی را در آرایههای کتابخانه NumPy ذخیره کنیم. ویژگی ndim تعداد ابعاد هر آرایه را برمیگرداند:
- تانسور ۰بعدی (اسکالر): میانگین نمره یک دانشآموز در یک درس را ذخیره میکند؛ یعنی یک عدد تنها.
- تانسور ۱بعدی (بردار): نمرات سه درس یک دانشجو را در یک آرایه خطی ذخیره میکند.
- تانسور ۲بعدی (ماتریس): نمرات سه درس یک دانشجو را که در هر درس سه بار امتحان داده است، در ساختار سطر و ستون ذخیره میکند.
- تانسور ۳بعدی: نمرات سه امتحان از سه درس یک دانشجو را در دو ترم مختلف، ترم اول و ترم دوم، ذخیره میکند. در یک تانسور ۳بعدی با ابعاد [فرمول] میتوان به ماتریس [فرمول] اُم، سطر [فرمول] و ستون [فرمول] اُم دسترسی داشت.
- تانسور ۴بعدی: تمام اطلاعات مسئله قبل (دو ترم، سه درس، سه امتحان) را برای سه دانشآموز متفاوت، مثلاً جیکوب، کریستین و سوفیا، ذخیره میکند.
import numpy as np
# 0D Tensor (Scalar) - میانگین نمره یک درس
tensor_0D = np.array(5)
print("0D Tensor dimensions:", tensor_0D.ndim)
# 1D Tensor (Vector) - نمرات سه درس
tensor_1D = np.array([4, 6, 8])
print("1D Tensor dimensions:", tensor_1D.ndim)
# 2D Tensor (Matrix) - نمرات ۳ امتحان در ۳ درس
tensor_2D = np.array([
[0, 1, 1], # درس ۱
[2, 3, 3], # درس ۲
[1, 3, 2] # درس ۳
])
print("2D Tensor dimensions:", tensor_2D.ndim)
# 3D Tensor - نمرات ۳ امتحان از ۳ درس در ۲ ترم
tensor_3D = np.array([
[[0, 1, 1], [2, 3, 3], [1, 3, 2]], # ترم اول
[[1, 3, 2], [2, 4, 2], [0, 1, 1]] # ترم دوم
])
print("3D Tensor dimensions:", tensor_3D.ndim)
# 4D Tensor - نمرات ۲ ترم، ۳ درس و ۳ امتحان برای ۳ دانشآموز
tensor_4D = np.array([
[[[0, 1, 1], [2, 3, 3], [1, 3, 2]], [[1, 3, 2], [2, 4, 2], [0, 1, 1]]], # دانشآموز ۱
[[[0, 3, 1], [2, 4, 1], [1, 3, 2]], [[1, 1, 1], [2, 3, 4], [1, 3, 2]]], # دانشآموز ۲
[[[2, 2, 4], [2, 1, 3], [0, 4, 2]], [[2, 4, 1], [2, 3, 0], [1, 3, 3]]] # دانشآموز ۳
])
print("4D Tensor dimensions:", tensor_4D.ndim)تعداد ابعاد تانسورها میتواند به مقدار دلخواه افزایش یابد. در پروژههای یادگیری عمیق، دادههای مختلف معمولاً در تانسورهایی با ابعاد استاندارد زیر ذخیره میشوند:
- دادههای سری زمانی (Time Series): تانسور ۳بعدی.
- تصاویر (Images): تانسور ۴بعدی. برای مثال، اگر ۶۴ عکس رنگی با ابعاد ۲۲۴×۲۲۴ پیکسل داشته باشیم، دادهها در یک تانسور ۴بعدی با اندازه [فرمول] قرار میگیرند، زیرا هر پیکسل رنگی ۳ کانال (RGB) دارد.
- ویدیوها (Videos): تانسور ۵بعدی.
گراف محاسباتی (Computational Graph) و اجرای موازی
گراف محاسباتی (Computational Graph) یک گراف بدون دور است که جریان داده و عملیات را در تنسورفلو مدلسازی میکند. «گرهها» (Nodes) عملیات ریاضی مانند جمع، ضرب ماتریسی یا توابع فعالساز را نشان میدهند. «یالها» (Edges) نیز نمایشدهنده تانسورهایی هستند که در جایگاه ورودی و خروجی بین این عملیات جریان دارند. گرههای برگ، یعنی رئوسی که یال ورودی ندارند، همیشه تانسور هستند؛ زیرا هیچ عملیاتی در ابتدای گراف نمیتواند بدون دریافت تانسور ورودی رخ دهد. هر عملیات نیز پس از اجرا، تانسور جدیدی تولید میکند.
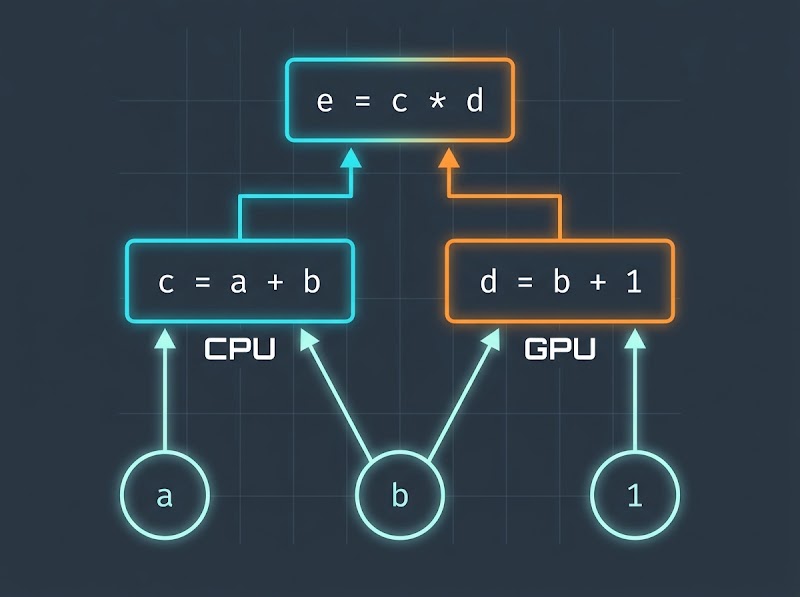
این گراف محاسبات را با ترتیبی سلسلهمراتبی سازماندهی میکند. برای نمونه، عبارت [فرمول] را میتوان با تعریف زیرعبارتهای [فرمول] و [فرمول] به شکل [فرمول] نوشت. در پیمایش روبهجلوی این گراف، محاسبه گره [فرمول] به خروجی گرههای [فرمول] و [فرمول] وابسته است. خود گره [فرمول] به [فرمول] و [فرمول] و گره [فرمول] به [فرمول] وابستگی دارد.
عملیات گرههای همسطح در این ساختار از یکدیگر مستقل هستند. در مثال بالا، برای محاسبه مقدار [فرمول] نیازی به دانستن نتیجه [فرمول] نیست. تنسورفلو از این استقلال برای پردازش موازی (Parallelism) و اجرای توزیعشده (Distributed Execution) استفاده میکند. به این ترتیب، گرههای همسطح بدون انتظار برای یکدیگر، همزمان اجرا میشوند. برای مثال، عملیات [فرمول] میتواند روی CPU پردازش شود و عملیات [فرمول] بهطور موازی روی GPU اجرا شود.
در اجرای توزیعشده، تنسورفلو گراف را بخشبندی میکند و عملیات را میان چندین پردازنده یا ماشین تقسیم میکند. «کارگرها» (Workers) این فرآیند را مدیریت میکنند و وظیفه زمانبندی وظایف (Task Scheduling) روی منابع سختافزاری مختلف را دارند. پس از پایان محاسبات در هر دستگاه، نتیجه در قالب تانسور به گره سطح بالاتر منتقل میشود تا خروجی نهایی شکل بگیرد.
اجرای مشتاقانه (Eager Execution) در تنسورفلو ۲
در نسخه ۱.۰ تنسورفلو، محاسبات بر پایه یک «گراف محاسباتی استاتیک» (Static Computation Graph) انجام میشد. برنامهنویس ابتدا باید کل ساختار مدل و گراف را تعریف میکرد. سپس، در مرحلهای جداگانه، دادهها را در قالب یک «نشست» (Session) به گراف میخوراند. در خلال این نشست، به متغیرهای گراف فضای حافظه اختصاص داده میشد تا عملیات اجرا شوند. جدایی مرحله تعریف از مرحله اجرا، بررسی مقادیر میانی کد را دشوار میکرد.
در تنسورفلو ۲، «اجرای مشتاقانه» (Eager Execution) بهعنوان حالت پیشفرض فعال شده است. این قابلیت از اصول برنامهنویسی دستوری (Imperative Programming) پیروی میکند و باعث میشود پردازشها و عملیات ریاضی بلافاصله پس از فراخوانی توسط پایتون و بدون نیاز به ایجاد نشست مجزا اجرا شوند. در نتیجه، توسعهدهندگان میتوانند کدها را خطبهخط بررسی کنند؛ این امکان، ساخت سریع نمونه اولیه (Prototyping) و اشکالزدایی (Debugging) مدلها را آسانتر میکند.
اجزای اکوسیستم تنسورفلو و ابزارهای جانبی
تنسورفلو در کنار کتابخانه تعریف عملیات ریاضی، مجموعهای از ابزارها، کتابخانهها و سختافزارهای مکمل دارد. این مجموعه به توسعهدهندگان کمک میکند چرخه ساخت مدل را مدیریت کنند؛ از طراحی، آموزش و مصورسازی مدل تا استقرار آن روی مرورگرها، سرورها و دستگاههای موبایل.
TensorBoard چیست و چه کاربردی دارد؟
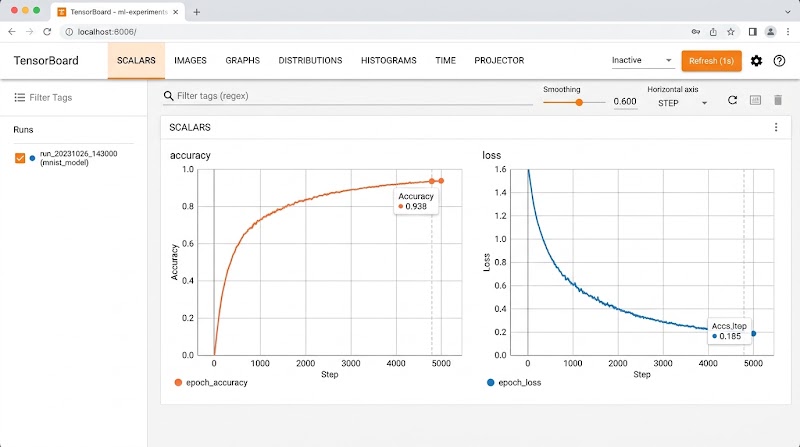
TensorBoard چارچوب مصورسازی (Visualization) یکپارچه برای TensorFlow و Keras است. کاربران با این ابزار میتوانند فرآیند آموزش مدل، گرافهای محاسباتی زیربنایی و معیارهای ارزیابی (Metrics) را بهصورت بصری دنبال کنند. این نظارت بصری برای اشکالزدایی (Debugging) اجراهای مختلف کد و سنجش دقیق عملکرد مدل به کار میرود.
رابط سطح بالای Keras
کراس (Keras) با نام ماژول tf.keras مستقیماً در تنسورفلو ادغام شده و رابط برنامهنویسی (API) رسمی و سطح بالای آن است. این ابزار با سادهسازی انتزاعهای تنسورفلو، یک API ساده برای ساخت مدلهای یادگیری عمیق در کاربردهای رایج فراهم میکند. هدف اصلی طراحی Keras این است که توسعهدهندگان بتوانند ایدههای خود را در کمترین زمان ممکن به نتیجه و مدل عملیاتی تبدیل کنند.
اگر میخواهید ساخت شبکههای عصبی با این دو ابزار را گامبهگام دنبال کنید، دوره یادگیری عمیق با TensorFlow و Keras در مکتبخونه مسیر مناسبی برای شماست.

تنسورفلو لایت (TensorFlow Lite) و واحد پردازش تانسور (TPU)
تنسورفلو لایت (TensorFlow Lite) یک پشته نرمافزاری سبک است که در می ۲۰۱۷ برای اجرای مدلهای یادگیری ماشین روی دستگاههای موبایل (اندروید و iOS)، سیستمهای توکار لینوکسی (مانند Raspberry Pi) و میکروکنترلرها (مانند Arm Cortex-M) معرفی شد. این ابزار روی دستگاههای دارای محدودیت منابع، امکان پیشبینی بلادرنگ، آفلاین و با تأخیر کم را بدون وابستگی به پردازش ابری فراهم میکند. تیم تنسورفلو همچنین در ژوئن ۲۰۱۹ موتور استنتاج GPU موبایل را بر پایه OpenGL ES ۳.۱ Compute Shaders برای اندروید و Metal Compute Shaders برای iOS منتشر کرد.
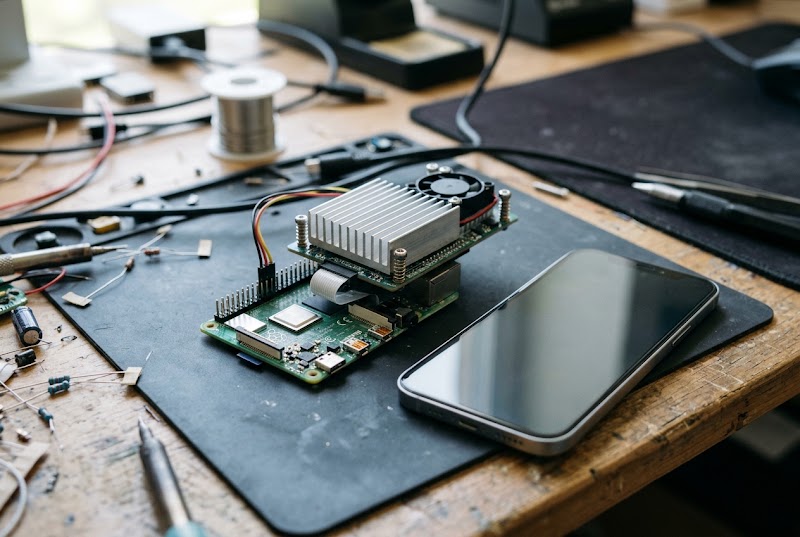
گوگل در بخش سختافزار، «واحد پردازش تانسور» (Tensor Processing Unit یا TPU) را در می ۲۰۱۶ معرفی کرد. TPU یک مدار مجتمع با کاربرد خاص (ASIC) و شتابدهنده هوش مصنوعی قابل برنامهریزی است. این تراشه برای توان عملیاتی (Throughput) بالا در محاسبات دقت پایین، مانند محاسبات ۸ بیتی، و بهینهسازی توان مصرفی به ازای هر وات طراحی شده است. نسل دوم این تراشهها در می ۲۰۱۷ برای موتور محاسبه گوگل، با کارایی تا ۱۸۰ ترافلاپس و در خوشههای ۶۴تایی تا ۱۱.۵ پتافلاپس، و در فوریه ۲۰۱۸ برای پلتفرم گوگل کلود معرفی شد. تراشه اختصاصی Edge TPU نیز در جولای ۲۰۱۸ برای رایانش لبهای (Edge Computing) و اجرای مدلهای TensorFlow Lite روی دستگاههای کوچک عرضه شد. گوشی گوگل پیکسل ۲، منتشرشده در اکتبر ۲۰۱۷، هم به تراشه «پیکسل ویژوال کور» (Pixel Visual Core یا PVC) مجهز است. این تراشه پردازنده تصویر، بینایی و هوش مصنوعی در موبایل است و از تنسورفلو پشتیبانی میکند.
سایر ابزارهای اکوسیستم (TensorFlow.js، TFX و Hub)
ابزارها و کتابخانههای مکمل دیگر در اکوسیستم تنسورفلو عبارتاند از:
- TensorFlow Core: رابط برنامهنویسی (API) پایه تنسورفلو است. کاربران با این رابط میتوانند مدلها را تعریف کنند، محاسبات را بسازند و آنها را اجرا کنند.
- TensorFlow.js: کتابخانهای است که در ژانویه ۲۰۱۹ منتشر شد. برای آموزش و اجرای مستقیم مدلهای یادگیری ماشین و یادگیری عمیق در مرورگر و برنامههای وب، با استفاده از مباحث آموزش جاوا اسکریپت، به کار میرود.
- TensorFlow Extended (TFX): راهحلی آماده بهرهبرداری برای استقرار مدلهای یادگیری ماشین در محیطهای عملیاتی (Production) است.
- TensorFlow Hub: مخزنی آنلاین برای اشتراکگذاری مدلهای ازپیشآموزشدیده (Pre-trained Models) است. توسعهدهندگان میتوانند این مدلها را بهسادگی در برنامههای خود ادغام کنند.
ویژگیها و مزایای استفاده از تنسورفلو
توسعهدهندگان و پژوهشگران برای طراحی و اجرای مدلهای یادگیری ماشین، به دلایل فنی زیر از تنسورفلو استفاده میکنند:
- مقیاسپذیری و اجرای چندسکویی: تنسورفلو روی سیستمعاملهای ۶۴ بیتی لینوکس، ویندوز، macOS، پلتفرمهای موبایل (اندروید و iOS) و محیطهای ابری مانند Google Cloud Platform اجرا میشود. به این ترتیب، میتوان مدلها را بدون بازنویسی کد، از یک سیستم دسکتاپ یا دستگاههای توکار (Embedded) تا خوشههای بزرگ سرور آموزش داد و اجرا کرد.
- مشتقگیری خودکار (Automatic Differentiation / Autograd): این کتابخانه گرادیان تمام متغیرهای قابل آموزش مدل را خودکار محاسبه میکند. این قابلیت، فرآیند پسانتشار خطا (Backpropagation) را در مرحله آموزش ساده میکند و به بهینهسازی مدل با تکنیکهایی مانند گرادیان کاهشی (Gradient Descent) سرعت میبخشد.
- پشتیبانی از چند زبان: تنسورفلو برای پایتون و زبان C، API پایدار دارد. برای C++، جاوا، جاوااسکریپت، Go و Swift نیز رابطهایی دارد که تضمین سازگاری عقبرو ندارند. بستههای شخص ثالث برای C#، R، Julia، Rust، Scala، Haskell، OCaml و Crystal هم در دسترس است تا برنامهنویسان مسلط به سایر زبانهای برنامهنویسی بتوانند از قابلیتهای این فریمورک استفاده کنند.
- بهینهسازی و استقرار مدل: ابزار TensorFlow Serving استقرار مدلها را در محیطهای عملیاتی مدیریت میکند. تکنیکهای بهینهسازی مانند کوانتیزهسازی (Quantization)، هرس کردن (Pruning) و خوشهبندی وزنها (Weight Clustering) نیز حجم مدل و مصرف حافظه را کاهش میدهند تا سرعت استنتاج (Inference) افزایش یابد و تأخیر (Latency) کمتر شود.
کاربردهای تنسورفلو در دنیای واقعی و شرکتهای بزرگ
شرکتها و مراکز تحقیقاتی از TensorFlow در مقیاس صنعتی برای حوزههای آموزش پردازش تصویر، پردازش زبان طبیعی (NLP)، تحلیل سریهای زمانی و تشخیص گفتار استفاده میکنند:
- گوگل (Google): گوگل در سرویسهایی مانند جیمیل، Google Photos و جستوجوی صوتی از مدلهای تنسورفلو استفاده میکند. الگوریتم موتور جستوجوی RankBrain و نرمافزار توضیحاتنویسی خودکار تصویر DeepDream با این کتابخانه توسعه یافتهاند. RankBrain کوئریهای جستوجو را پردازش میکند و نتایج الگوریتمهای سنتی را تکمیل میکند.
- ایرباس (Airbus): این شرکت هوافضا برای استخراج و تحلیل اطلاعات تصاویر ماهوارهای و ارائه دادههای بلادرنگ به مشتریان خود از تنسورفلو استفاده میکند.
- پیپال (PayPal): پیپال با استفاده از یادگیری انتقالی عمیق (Deep Transfer Learning) و مدلسازی مولد در تنسورفلو، الگوهای پیچیده و متغیر تقلب (Fraud) را شناسایی میکند. همزمان، فرآیند احراز هویت مشتریان واقعی را نیز سرعت میبخشد.
- تسلا (Tesla): این شرکت در توسعه سیستمهای هوش مصنوعی خودروها و فناوری خودروهای خودران خود از TensorFlow استفاده میکند.
- توییتر (Twitter): توییتر قابلیت تایملاین رتبهبندیشده (Ranked Timeline) را با تنسورفلو پیادهسازی کرده است تا کاربران حتی در صورت دنبال کردن هزاران حساب کاربری، مهمترین توییتها را در اولویت ببینند.
- سایر شرکتها و مراکز: شرکت کاکائو (Kakao) از الگوریتمهای سری زمانی در تنسورفلو برای پیشبینی نرخ تکمیل درخواستهای تاکسی اینترنتی استفاده میکند. شرکت مخابراتی SwissCom با ساخت مدلهای سفارشی دستهبندی متن، نیت مشتریان را هنگام دریافت تماس تشخیص میدهد. مرکز علمی NERSC نیز توانسته است یک برنامه علمی یادگیری عمیق را با کمک تنسورفلو روی بیش از ۲۷ هزار پردازنده گرافیکی NVIDIA V100 مقیاسدهی کند. شرکتهای آمازون برای رباتیک، تشخیص الگو و پردازش گفتار، فیسبوک برای تشخیص ویدیو و تصویر و مایکروسافت برای ترجمه متن و تشخیص صدا و تصویر، از این فریمورک در محصولات خود استفاده میکنند.
مقایسه TensorFlow با PyTorch، Keras و Scikit-Learn
برای انتخاب فریمورک مناسب در پروژههای آموزش هوش مصنوعی، باید تفاوتهای ساختاری و کاربردی ابزارها را با توجه به نیاز پروژه بررسی کنید. جدول زیر ویژگیهای TensorFlow، PyTorch، Keras و Scikit-Learn را کنار هم قرار میدهد:
| ویژگی | TensorFlow | PyTorch | Keras | Scikit-Learn |
|---|---|---|---|---|
| تمرکز اصلی | یادگیری عمیق و محیط عملیاتی (Production) | پژوهش و آزمایش (Experimentation) | API سطح بالای یادگیری عمیق (روی TensorFlow) | یادگیری ماشین سنتی (SVM، درختها، رگرسیون) |
| قابلیت استقرار (Deployment) | قوی (Lite، JS، Serving) | محدودتر در مقایسه با TensorFlow | استفاده از خط لوله TensorFlow | تمرکز حداقلی بر استقرار |
| سهولت استفاده | متوسط، نیازمند راهاندازی اولیه | آسان و منعطف | بسیار آسان (مناسب افراد مبتدی) | ساده برای وظایف کوچک یادگیری ماشین |
| انعطافپذیری | مناسب برای محیط عملیاتی، کمتر برای پژوهش | بسیار منعطف | محدودتر نسبت به TensorFlow خام | محدود (بدون یادگیری عمیق) |
| موارد استفاده | NLP، بینایی ماشین، یادگیری تقویتی، محیط عملیاتی | پژوهش، نمونهسازی اولیه (Prototyping) | ساخت سریع مدلهای یادگیری عمیق | دستهبندی، خوشهبندی، رگرسیون |
| شبکههای عصبی | قوی (CNN، RNN، RL) | قوی (RNN، GAN، LSTM) | ساخت سادهشده شبکههای عصبی | مناسب یادگیری عمیق نیست |
| منحنی یادگیری | شیب تند اما قدرتمند | آسانتر برای پژوهش، پیچیده برای محیط عملیاتی | آسانترین | آسان |
| جامعه کاربری | بزرگ و در حال رشد | در حال رشد، متمرکز بر پژوهش | بخشی از اکوسیستم TensorFlow | بزرگ (فقط یادگیری ماشین کلاسیک) |
انتخاب ابزار به هدف پروژه بستگی دارد. اگر میخواهید الگوریتمهای کلاسیک مانند رگرسیون، خوشهبندی یا درخت تصمیم را برای وظایف کوچک پیادهسازی کنید، Scikit-Learn انتخابی ساده و مستقیم برای یادگیری ماشین با پایتون است و به ابزارهای یادگیری عمیق نیاز ندارید. برای طراحی شبکههای عصبی، PyTorch به دلیل انعطافپذیری بالا در پروژههای تحقیقاتی و نمونهسازی سریع کاربرد دارد. اگر اولویت شما استقرار مدل در محیطهای عملیاتی، موبایل یا وب است، TensorFlow ابزارهای کاملتری در اختیارتان میگذارد و رابط Keras در کنار آن به شروع سریعتر کار کمک میکند.
آموزش نصب تنسورفلو و راهاندازی محیط کاری
برای شروع کدنویسی و توسعه مدلهای یادگیری عمیق، دو راه اصلی دارید. میتوانید کتابخانه تنسورفلو را روی سیستم محلی خود، با ویندوز، لینوکس یا macOS، نصب کنید یا از محیطهای ابری استفاده کنید. محیطهای ابری بدون نیاز به نصب و تنظیمات اولیه، منابع پردازشی آماده را در اختیارتان میگذارند. انتخاب روش به سختافزار سیستم شما و نیاز پروژه به پردازندههای گرافیکی بستگی دارد. هر دو روش را بررسی میکنیم.
نصب تنسورفلو با pip و در محیط Anaconda
برای نصب تنسورفلو روی کامپیوتر محلی، بهتر است ابتدا یک محیط مجازی جداگانه در پایتون یا، در صورت استفاده از Anaconda، یک محیط conda بسازید و آن را فعال کنید. این کار از تداخل بستههای مختلف در پروژههای شما جلوگیری میکند.
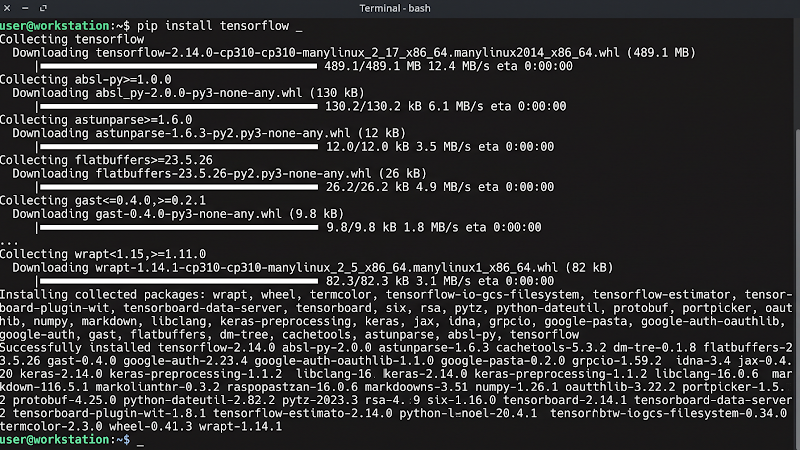
پس از فعال کردن محیط مجازی، ترمینال یا Command Prompt را باز کنید و دستور زیر را برای دریافت و نصب کتابخانه اجرا کنید:
pip install tensorflowبرای اطمینان از اینکه نصب tensorflow در anaconda یا محیط پایتون بهدرستی انجام شده است، میتوانید نصب را از طریق ترمینال بررسی کنید. راه دیگر این است که وارد ژوپیتر نوتبوک (Jupyter Notebook) شوید و دستورات فراخوانی کتابخانه را اجرا کنید. اگر هم قصد دارید اسکریپتهای خود را در یک محیط کدنویسی یکپارچه روی سیستم محلی توسعه دهید، راهنمای آموزش نصب پایچارم به آمادهسازی محیط کار کمک میکند.
اجرای تنسورفلو روی GPU و استفاده از Google Colab
واحدهای پردازش گرافیکی (GPU) به دلیل معماری موازی و داشتن هزاران هسته کوچک، میتوانند هزاران ترد (Thread) موازی را همزمان اجرا کنند. یادگیری عمیق به عملیات ماتریسی و محاسبات جبری وابسته است. از طرفی، تنسورفلو با زبان C++ بهینهشده و ابزار NVIDIA CUDA Toolkit نوشته شده است. به همین دلیل، قرار دادن تانسورها روی GPU سرعت آموزش و استنتاج مدل را افزایش میدهد؛ زمان آموزش از چند روز به چند ساعت کاهش مییابد و روی پردازندههای گرافیکی NVIDIA Pascal تا ۵۰ درصد سریعتر اجرا میشود.
پشتیبانی تنسورفلو از GPU روی سیستم محلی به نصب چندین درایور و کتابخانه نیاز دارد. برای سادهتر شدن نصب و جلوگیری از تداخل کتابخانهها، بهتر است از ایمیج Docker تنسورفلو با پشتیبانی از GPU استفاده کنید. در این روش فقط به درایورهای کارت گرافیک NVIDIA و نصب NVIDIA-docker نیاز دارید. سپس میتوانید کانتینرهای ازپیشتنظیمشده را که حاوی کتابخانه تنسورفلو و مدلهای آماده هستند، از پلتفرم NGC (NVIDIA GPU Cloud) دریافت کنید.
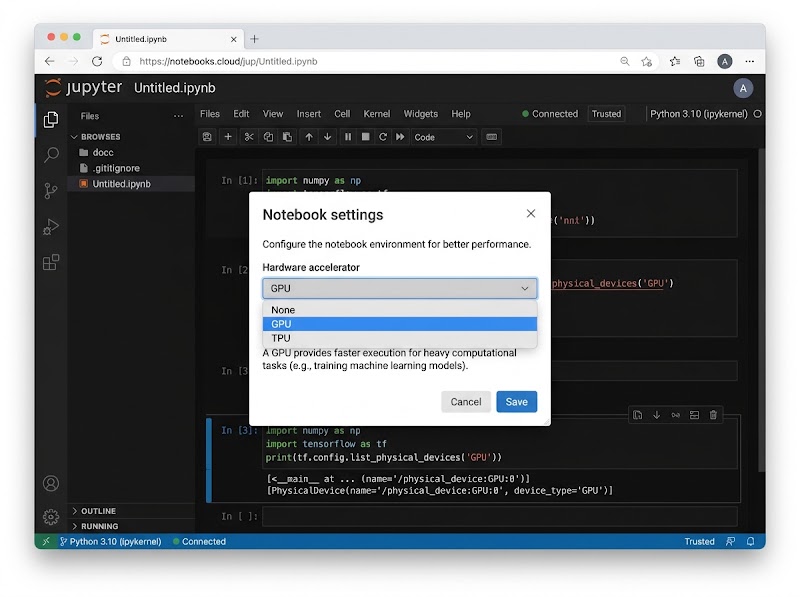
اگر به سختافزار قدرتمند دسترسی ندارید یا نمیخواهید درگیر نصب درایورها شوید، Google Colaboratory، یا به اختصار Colab، جایگزین مناسبی است. کلب یک محیط نوتبوک ژوپیتر ابری برای تنسورفلو است که به نصب نیاز ندارد. فایلهای شما را در گوگل درایو ذخیره میکند و برای هر بار اجرا تا ۱۲ ساعت دسترسی رایگان به GPU میدهد. برای استفاده از پردازنده گرافیکی در Colab، این مراحل را انجام دهید:
- در محیط نوتبوک به مسیر Edit > Notebook settings بروید و شتابدهنده زمان اجرا را روی حالت GPU قرار دهید.
- در صورت نصب تنسورفلو ۲.۰ روی کلب، اگر پیغامی مبنی بر نیاز به بازنشانی زمان اجرا (Runtime) دریافت کردید، آن را تأیید و بازنشانی کنید تا تغییرات اعمال شود.
مراحل ساخت و آموزش یک مدل ساده با TensorFlow در پایتون
چرخه کاری (Workflow) توسعه پروژه در تنسورفلو سه بخش اصلی دارد: پیشپردازش دادهها، ساخت مدل و آموزش آن برای پیشبینی. پس از آموزش و ارزیابی مدل روی کامپیوتر یا فضای ابری، اگر قرار باشد مدل روی موبایل یا سیستمهای نهفته اجرا شود، این مراحل تکمیلی طی میشوند:
- تبدیل مدل: مدل آموزشدیده با ابزار TFLite Converter به فرمت .tflite تبدیل میشود.
- بهینهسازی: تکنیکهایی مانند Quantization، Pruning یا Weight Clustering حجم مدل و مصرف حافظه را کاهش میدهند.
- استقرار و استنتاج در لبه: فایل به دستگاه مقصد منتقل میشود و پیشبینیهای بلادرنگ و آفلاین به کمک TFLite Interpreter اجرا میشوند.
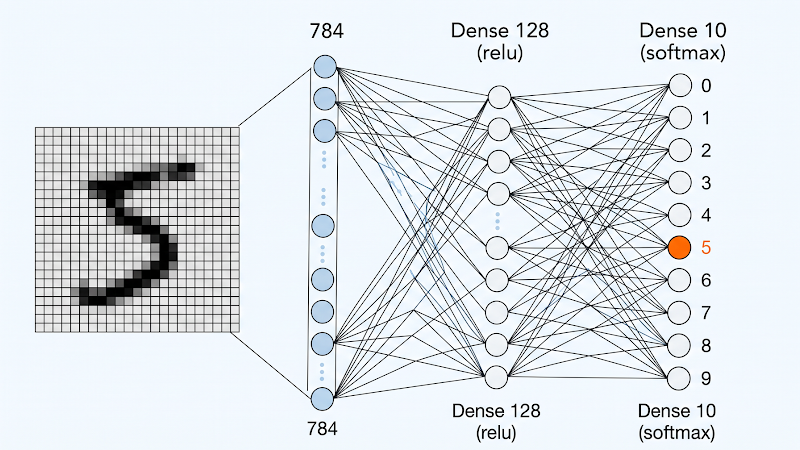
برای تمرین ساخت و آموزش مدل، یک شبکه عصبی ساده را با استفاده از Sequential API روی دیتاست تصاویر اعداد دستنویس (MNIST) پیادهسازی میکنیم:
from tensorflow.keras.datasets import mnist
from tensorflow.keras.layers import Dense
from tensorflow.keras.models import Sequential
import tensorflow as tf
# 1. بارگذاری و پیشپردازش دادهها
(train_images, train_labels), (test_images, test_labels) = mnist.load_data()
train_images = train_images.reshape((train_images.shape[0], 28 * 28)).astype('float32') / 255
test_images = test_images.reshape((test_images.shape[0], 28 * 28)).astype('float32') / 255
# 2. تعریف معماری شبکه عصبی
model = Sequential([
Dense(128, activation='relu', input_shape=(28 * 28,)),
Dense(10, activation='softmax')
])
# 3. کامپایل کردن مدل
model.compile(optimizer='adam', loss='sparse_categorical_crossentropy', metrics=['accuracy'])
# 4. آموزش مدل
model.fit(train_images, train_labels, epochs=5)
# 5. ارزیابی دقت روی دادههای تست
test_loss, test_acc = model.evaluate(test_images, test_labels)
print(f"Test accuracy: {test_acc}")ساخت و اجرای مدل در این کد در ۵ گام انجام میشود:
- بارگذاری و نرمالسازی: ابتدا دیتاست MNIST به دو بخش آموزش و تست تقسیم میشود. سپس هر تصویر با تغییر شکل (Reshape) به یک آرایه تخت با اندازه ۲۸ * ۲۸ تبدیل میشود. نوع دادهها به float32 تغییر میکند و مقادیر پیکسلها با تقسیم بر عدد ۲۵۵ نرمالسازی میشوند.
- تعریف لایهها: مدل با Sequential ساخته میشود و دو لایه متراکم (Dense) دارد. لایه اول ۱۲۸ نورون با تابع فعالساز relu دارد و لایه خروجی شامل ۱۰ نورون با تابع فعالساز softmax است.
- کامپایل مدل: در متد compile، بهینهساز adam، تابع زیان sparse_categorical_crossentropy و معیار ارزیابی دقت (accuracy) برای هدایت فرآیند یادگیری تنظیم میشوند.
- آموزش و ارزیابی: متد fit مدل را در ۵ دوره (epochs=۵) روی دادههای آموزشی تمرین میدهد. در پایان، متد evaluate عملکرد و دقت مدل را روی دادههای دیدهنشده (test_images) میسنجد و نتیجه را چاپ میکند.
اگر پس از اجرای این مدل پایه قصد دارید وارد مباحث سفارشیسازی شبکهها و استقرار مدلهای پیچیده شوید، دوره آموزش تنسورفلو پیشرفته در مکتبخونه گام بعدی مناسبی برای شما خواهد بود.