پایتورچ (PyTorch) یک فریمورک متنباز برای یادگیری عمیق (Deep Learning) و یادگیری ماشین است. با این ابزار میتوان شبکههای عصبی را روی پردازندههای مرکزی (CPU) و کارتهای گرافیک (GPU) ساخت، آموزش داد و اجرا کرد. پایتورچ از ساختارهای داده چندبعدی به نام تنسور و سیستم مشتقگیری خودکار استفاده میکند و مسیر نمونهسازی پژوهشی تا استقرار مدلهای هوش مصنوعی در محیطهای عملیاتی را سرعت میبخشد.
این فریمورک بر پایه زبان پایتون طراحی شده است. ساختار پایتونیک آن باعث میشود کدنویسی و خطایابی مدلها شباهت زیادی به برنامهنویسی استاندارد پایتون داشته باشد؛ به همین دلیل، نخستین قدم برای تسلط بر این ابزار، آموزش پایتون است. در کنار هسته اصلی پایتورچ، کتابخانههای جانبی متعددی نیز توسعه یافتهاند. مهمترین آنها در حوزه تصویر، Torchvision است که ابزارهای پیشپردازش و دیتاستهای آماده بینایی ماشین را در اختیار برنامهنویس قرار میدهد.
پس از بررسی ویژگیها و کاربردهای صنعتی پایتورچ، ۴ جزء اصلی معماری آن، یعنی تنسورها، Autograd، ماژول nn و بهینهسازها را همراه با کدهای پایتون بررسی میکنیم. سپس کار با Torchvision را در یک پروژه عملی برای تشخیص اعداد دستنویس (MNIST) پیادهسازی میکنیم و پس از آن، محدودیتهای PyTorch و تفاوتهای آن با TensorFlow را مقایسه خواهیم کرد.
کتابخانه PyTorch چیست و چرا محبوب است؟
برای پاسخ دقیق به این پرسش که پایتورچ چیست، باید به ریشههای توسعه آن بازگردیم. تیم پژوهش هوش مصنوعی فیسبوک (Facebook) کتابخانه پایتورچ را در سال ۲۰۱۶ معرفی کرد. نسخه ۱.۰ آن نیز در اوایل سال ۲۰۱۸، در یکپارچگی با سرویسهای ابری Google Cloud، سرویسهای وب آمازون (AWS) و Azure Machine Learning انتشار یافت. پایتورچ نسخه بازنویسیشده و پایتونی فریمورک قدیمیتر «تورچ» (Torch) است که بر پایه زبان برنامهنویسی Lua ساخته شده بود.
برای شناخت جایگاه پایتورچ در مسیر آشنایی با هوش مصنوعی، باید توجه داشت که یادگیری عمیق، موضوع آموزش یادگیری عمیق، زیرمجموعهای از یادگیری ماشین است که از الگوریتمهای الهامگرفته از ذهن انسان، یعنی «شبکههای عصبی مصنوعی» (ANN)، استفاده میکند. شبکههای عصبی پیچشی (CNN) و بازگشتی (RNN) از همین دستهاند. پرسش بسیاری از توسعهدهندگان این است که مزیت رقابتی Pytorch چیست و چرا میان پژوهشگران و مهندسان محبوبیت بالایی دارد؟ پاسخ به دو قابلیت اصلی برمیگردد: محاسبات تنسوری با شتابدهی سختافزاری GPU و مشتقگیری خودکار بر پایه گرافهای پویا که انعطافپذیری بالایی برای تغییر معماری مدل ایجاد میکنند.
ویژگیهای اصلی پایتورچ
قابلیتهای فنی زیر پایتورچ را از سایر ابزارهای یادگیری عمیق متمایز میکنند:
- پایتورچ از گراف محاسباتی پویا (Dynamic Computation Graphs) و رویکرد تعریف در حین اجرا (Define-by-run) پیروی میکند. در رویکردهای قدیمیتر، کاربر مجبور بود کل گراف محاسباتی را پیش از اجرای مدل به صورت ایستا تعریف کند. در پایتورچ، برنامهنویس میتواند ساختار گراف و مدل را هنگام اجرا تغییر دهد؛ قابلیتی که برای آزمایشهای پژوهشی و دیباگ کردن کدها بسیار کاربردی است.
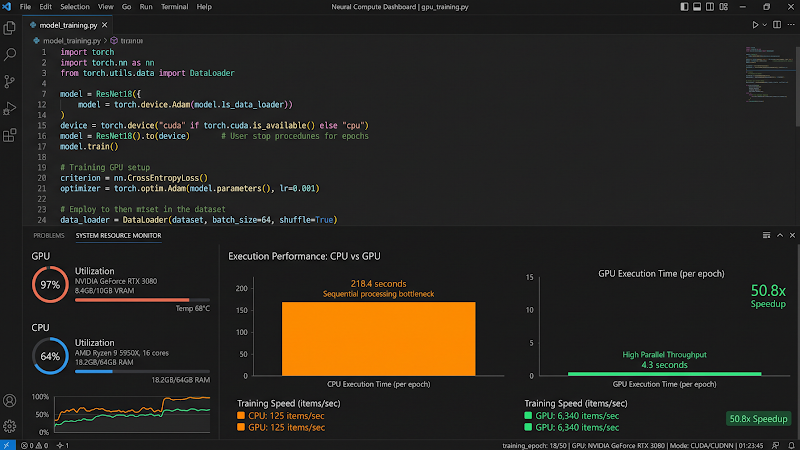
- اجرای پیشفرض پایتورچ روی CPU است، اما پشتیبانی مستقیم از فناوری CUDA امکان انتقال محاسبات سنگین به کارت گرافیک (GPU) را فراهم میکند. این شتابدهی سختافزاری در محاسبات عددی، سرعت آموزش شبکههای عصبی را تا ۵۰ برابر یا بیشتر افزایش میدهد.
- ساختار پایتونیک PyTorch کدنویسی را ساده و خوانا میکند. کدهای آن با ساختارهای بومی زبان پایتون یکپارچهاند و برنامهنویس میتواند برای خطایابی (Debugging) از ابزارهای استاندارد پایتون استفاده کند.
- این فریمورک به راحتی با کتابخانههای علمی و پرکاربرد پایتون، مانند NumPy و Scikit-Learn، ادغام میشود. تبادل داده میان این کتابخانهها نیز پیچیدگی ندارد.
- کتابخانههای مکملی مانند torchvision، torchtext و torchaudio، همراه با جامعه کاربری فعال و پشتیبانی انجمنهای تخصصی، توسعه پروژههای چندرسانهای را سرعت میبخشند.
پیشنیازهای شروع کار با PyTorch
پایتورچ یک کتابخانه سطح بالا بر پایه پایتون است. پیش از شروع یادگیری عمیق با این ابزار، باید بر مفاهیم پایه آموزش برنامهنویسی و ساختارهای داده، شرطها، حلقهها و شیءگرایی در زبان پایتون مسلط باشید. اگر هنوز سینتکس این زبان را نمیشناسید، دوره مقدماتی پایتون نقطه شروع مناسبی خواهد بود.
علاوه بر پایتون، آشنایی با چهار بسته نرمافزاری زیر از پیشنیازهای مهم کار با دادهها و درک ساختار تنسورهاست:
- NumPy به درک آرایههای چندبعدی و عملیات آموزش جبر خطی کمک میکند؛ آرایههای چندبعدی پایه تنسورهای پایتورچ هستند.
- Pandas برای خواندن، پاکسازی و مدیریت دادههای جدولی پیش از ورود آنها به شبکه عصبی کاربرد دارد.
- SciPy برای انجام محاسبات علمی و ریاضی پیشرفته کاربرد دارد.
- Scikit-Learn برای آشنایی با مفاهیم پایه آموزش یادگیری ماشین، معیارهای ارزیابی و تقسیمبندی دادهها کاربرد دارد.
کاربردهای پایتورچ در دنیای واقعی
انعطافپذیری در طراحی معماریهای سفارشی باعث شده است پایتورچ هم در تحقیقات دانشگاهی و هم در مقیاسهای صنعتی به کار گرفته شود. کاربردهای اصلی این فریمورک و نمونههایی از شرکتهای استفادهکننده از آن عبارتاند از:
حوزههای فنی و تخصصی:
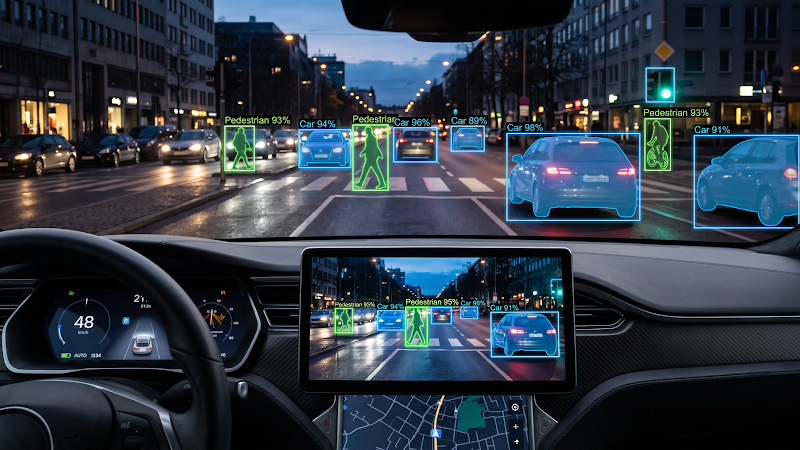
- در بینایی ماشین (Computer Vision)، پایتورچ برای پیادهسازی شبکههای عصبی پیچشی (CNN) و ترنسفورمرهای بینایی (ViT) کاربرد دارد. این شبکهها برای دستهبندی تصاویر (Image Classification)، تشخیص اشیا (Object Detection) و قطعهبندی تصویر (Segmentation) به کار میروند.
- برای پردازش زبان طبیعی (NLP)، با پایتورچ میتوان مدلهای مبتنی بر شبکههای عصبی بازگشتی (RNN)، شبکههای حافظه کوتاهمدت بلندمدت (LSTM) و معماری ترنسفورمرها (Transformers) را ساخت. تولید متن، ترجمه ماشینی و تحلیل احساسات از کاربردهای این مدلها هستند.
- این فریمورک در یادگیری تقویتی (Reinforcement Learning) و هوش مصنوعی مولد برای توسعه الگوریتمهای Deep Q-Networks (DQN)، روشهای Policy Gradient، الگوریتمهای Actor-Critic و مدلهای مولد (Generative AI) کاربرد دارد.
شرکتها و محصولات صنعتی:
- فیسبوک (متا) از پایتورچ برای توسعه و اجرای مدلهای مختلف یادگیری عمیق در سرویس پیامرسان مسنجر (Messenger) و شبکه اجتماعی اینستاگرام استفاده میکند.
- تسلا (Tesla) الگوریتمهای بینایی ماشین و تصمیمگیری در سیستم خودروهای خودران را با این فریمورک طراحی و آموزش میدهد.
- اوبر (Uber) از آن برای بهینهسازی الگوریتمهای مسیریابی هوشمند و سیستمهای پیشبینی تقاضای سفر در پلتفرم حملونقل استفاده میکند.
اجزای اصلی و ساختار PyTorch (همراه با کد)
ساختار کدنویسی و ساخت شبکه عصبی با PyTorch بر پایه چهار جزء اصلی است: تنسورها برای مدیریت دادهها، Autograd برای محاسبه مشتق، ماژول nn برای تعریف لایهها و بسته optim برای بهروزرسانی وزنها. هر یک از این اجزا را همراه با کد بررسی میکنیم.
تنسورها (Tensors)؛ ساختار داده پایه
تنسورها ساختارهای داده چندبعدی هستند و تمام محاسبات پایتورچ بر پایه آنها انجام میشود. تنسورهای پایتورچ شباهت زیادی به آرایههای NumPy دارند، اما میتوان آنها را علاوه بر CPU روی GPU نیز اجرا کرد. این تنسورها از مشتقگیری خودکار هم پشتیبانی میکنند. نوع پیشفرض تنسورها در پایتورچ، تنسور اعشاری یا شناور است که با کلاس torch.FloatTensor شناخته میشود.
کد زیر تنسورهای یکبعدی و دوبعدی را تعریف میکند و نحوه جمع عنصر به عنصر و ضرب ماتریسی (torch.matmul) را نشان میدهد:
import torch
# تعریف یک تنسور یکبعدی و یک تنسور دوبعدی از صفرها
x = torch.tensor([1.0, 2.0, 3.0])
y = torch.zeros((3, 3))
print("1D Tensor:\n", x)
print("2D Tensor:\n", y)
# عملیات جمع عنصر به عنصر و ضرب ماتریسی
a = torch.tensor([1.0, 2.0])
b = torch.tensor([3.0, 4.0])
addition = a + b
matrix_mul = torch.matmul(a.view(2, 1), b.view(1, 2))
print("Addition:\n", addition)
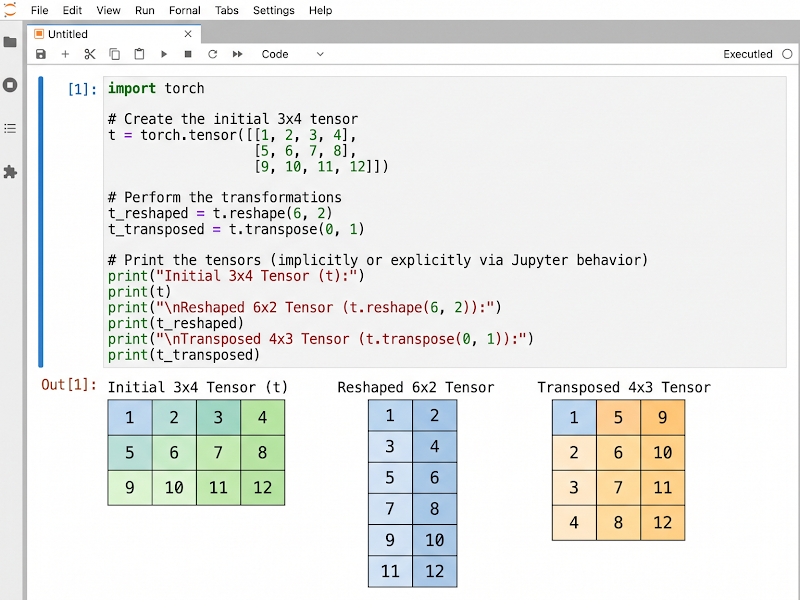
print("Matrix Multiplication:\n", matrix_mul)برای تغییر شکل ابعاد تنسور یا محاسبه ترانهاده ماتریس، از متدهای reshape()، view() و transpose() استفاده میشود. هر دو متد view() و reshape() ابعاد تنسور را بدون تغییر دادههای اصلی عوض میکنند، اما در نحوه کار با حافظه تفاوت دارند. متد view() به دادههایی نیاز دارد که به صورت پیوسته (Contiguous) در حافظه ذخیره شده باشند. متد reshape() انعطافپذیرتر است؛ اگر دادهها در حافظه پیوسته نباشند، در صورت نیاز یک کپی از داده ایجاد میکند.
import torch

t = torch.tensor([[1, 2, 3, 4], [5, 6, 7, 8], [9, 10, 11, 12]])

# تغییر ابعاد ماتریس ۳ در ۴ به ۶ در ۲
reshaped_t = t.reshape(6, 2)

# محاسبه ترانهاده ماتریس (جابجایی ابعاد ۰ و ۱)
transposed_t = t.transpose(0, 1)
print("Reshaped:\n", reshaped_t)
print("Transposed:\n", transposed_t)
ماژول Autograd و مشتقگیری خودکار
آموزش شبکه عصبی نیازمند تنظیم وزنها از طریق محاسبه مشتق تابع خطا نسبت به پارامترهاست. این محاسبه در «مسیر رو به عقب» (Backward pass یا Backpropagation) انجام میشود. در «مسیر رو به جلو» (Forward pass)، دادهها از چپ به راست حرکت میکنند و مسیر رو به عقب وزنها را از راست به چپ تنظیم میکند. بسته torch.autograd این فرآیند را با روش «مشتق خودکار» (Automatic Differentiation) انجام میدهد.
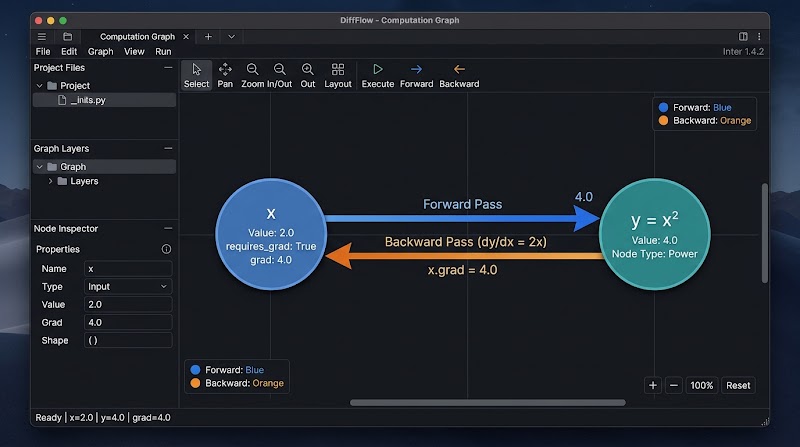
کلاسهای Tensor و Function در پایتورچ به هم متصل میشوند و یک گراف «غیرمدور» (Acyclic) میسازند که تاریخچه کامل محاسبات را ثبت میکند. وقتی ویژگی requires_grad=True را برای یک تنسور تنظیم میکنید، پایتورچ تمام عملیات روی آن را ردگیری میکند و تابع سازنده تنسور جدید را در خصیصه .grad_fn نگه میدارد.
برای محاسبه گرادیانها، متد .backward() فراخوانی میشود و حاصل مشتق در خصیصه .grad تنسور اولیه ذخیره میشود. اگر تنسور نهایی یک عدد اسکالر (تکعنصری) باشد، متد backward() به آرگومان نیاز ندارد. برای تنسوری با بیش از یک عنصر، باید یک تنسور همشکل به عنوان گرادیان به آن پاس داده شود.
import torch
# تعریف تنسور با قابلیت ردگیری گرادیان
x = torch.tensor(2.0, requires_grad=True)
# انجام عملیات ریاضی (ثبت در گراف محاسباتی)
y = x 2
# محاسبه مشتق در مسیر رو به عقب (dy/dx = 2x -> 2*2 = 4)
y.backward()
# چاپ مقدار گرادیان ذخیرهشده
print("Gradient of x:", x.grad) # خروجی: tensor(4.)وقتی به ردگیری تاریخچه محاسبات نیاز نداریم، مانند مرحله ارزیابی مدل، میتوانیم متد .detach() را روی تنسور فراخوانی کنیم تا از گراف جدا شود، یا بلوک کد را داخل عبارت with torch.no_grad(): قرار دهیم تا مصرف حافظه کاهش یابد.
ماژول nn.Module برای ساخت شبکه عصبی
ماژول torch.nn ابزارهای ساخت لایههای شبکه عصبی را فراهم میکند و در پسزمینه به autograd وابسته است. برای ساخت شبکه عصبی سفارشی در پایتورچ، یک کلاس جدید تعریف میکنیم که از کلاس پایه nn.Module ارثبری (Subclass) میکند. اجزای این ساختار چنین کار میکنند:
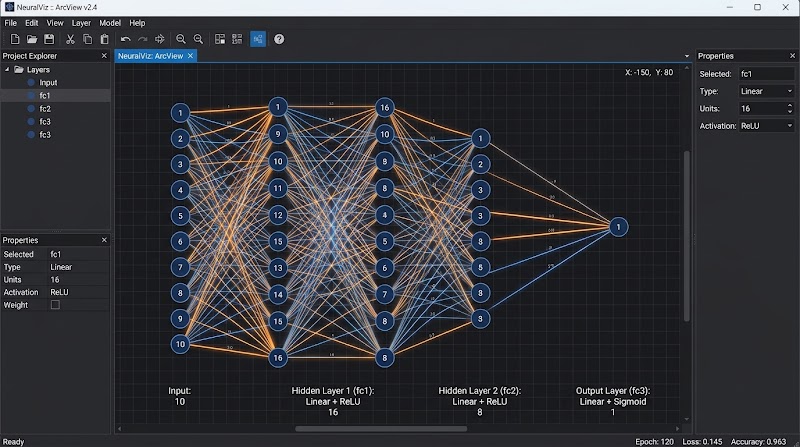
- لایههای خطی یا تماممتصل با nn.Linear(in_features, out_features) تعریف میشوند. این لایهها یک انتقال خطی روی ورودی اعمال میکنند.
- توابع فعالسازی (Activation Functions)، مانند torch.relu (واحد یکسوساز خطی)، torch.sigmoid یا torch.softmax، بین لایهها قرار میگیرند.
- متد forward() مشخص میکند تنسورهای ورودی چگونه از میان لایهها عبور میکنند و خروجی را تولید میکنند.
اگر شبکه یک پشته خطی و ساده از لایهها باشد، میتوان به جای تعریف کلاس از torch.nn.Sequential برای مقداردهی اولیه لایهها استفاده کرد. کد زیر یک شبکه سهلایه را با ارثبری از nn.Module تعریف میکند:
import torch
import torch.nn as nn

class NeuralNetwork(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(10, 16)  # لایه اول: ۱۰ ویژگی ورودی به ۱۶ گره پنهان
        self.fc2 = nn.Linear(16, 8)   # لایه دوم: ۱۶ گره به ۸ گره
        self.fc3 = nn.Linear(8, 1)    # لایه خروجی: ۸ گره به ۱ خروجی

    def forward(self, x):
        x = torch.relu(self.fc1(x))
        x = torch.relu(self.fc2(x))
        x = torch.sigmoid(self.fc3(x))
        return x

model = NeuralNetwork()
print(model)
بسته Optim و بهینهسازها
پس از محاسبه خطای مدل و به دست آوردن گرادیانها، وزنهای شبکه باید بر اساس یک قاعده ریاضی مانند weight = weight – learning_rate * gradient بهروزرسانی شوند. بسته torch.optim الگوریتمهای استاندارد بهینهسازی را برای انجام خودکار این کار در اختیار برنامهنویس قرار میدهد.
بهینهسازهای پرکاربرد این بسته عبارتاند از:
- SGD (گرادیان کاهشی تصادفی) الگوریتم پایه برای بهروزرسانی گامبهگام وزنهاست.
- Adam یکی از محبوبترین بهینهسازهاست و مزایای مومنتوم (Momentum) و نرخ یادگیری تطبیقی را ترکیب میکند.
- RMSProp و AdaGrad نرخ یادگیری را برای هر پارامتر به صورت تطبیقی تنظیم میکنند.
اولین آرگومانی که هر بهینهساز دریافت میکند، پارامترهای مدل (model.parameters()) است؛ یعنی همان تنسورهای وزنی که باید در طول آموزش اصلاح شوند. کد زیر تعریف کامل شبکه مثال قبلی و ایجاد بهینهساز برای آن را نشان میدهد:
import torch
import torch.nn as nn
import torch.optim as optim
class NeuralNetwork(nn.Module):
def __init__(self):
super().__init__()
self.fc1 = nn.Linear(10, 16)
self.fc2 = nn.Linear(16, 8)
self.fc3 = nn.Linear(8, 1)
def forward(self, x):
x = torch.relu(self.fc1(x))
x = torch.relu(self.fc2(x))
x = torch.sigmoid(self.fc3(x))
return x
model = NeuralNetwork()
# تعریف بهینهساز Adam با نرخ یادگیری 0.01
optimizer = optim.Adam(model.parameters(), lr=0.01)
print(optimizer)برای تسلط عملی بر تعریف تنسورها و کار با ماژولهای پایه، میتوانید از آموزشهای تخصصی مکتبخونه استفاده کنید.
کتابخانه Torchvision چیست و چه کاربردی دارد؟
در کنار هسته محاسباتی torch، پایتورچ کتابخانههای تخصصی برای انواع دادهها دارد: torchtext برای پردازش متن، torchaudio برای پردازش صوت و torchvision برای کار با تصاویر. اما کتابخانه Torchvision دقیقاً چیست؟
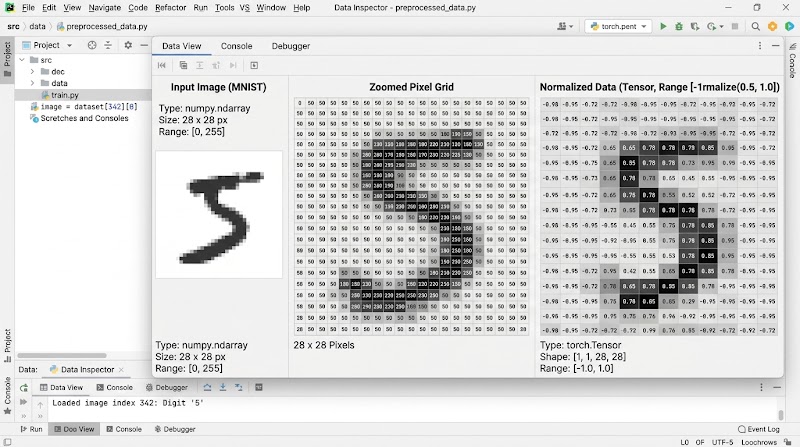
کتابخانه torchvision یک بسته جانبی رسمی در مجموعه کتابخانههای پایتورچ است که به طور اختصاصی برای پروژههای بینایی ماشین طراحی شده است. آمادهسازی تصاویر خام و تبدیل آنها به تنسورهای استاندارد، از بخشهای زمانبر کدنویسی در پروژههای واقعی است. Torchvision با ارائه دو ماژول اصلی این چالش را حل میکند:
- ماژول datasets دسترسی مستقیم به مجموعهدادههای معروف و استاندارد بینایی ماشین، مانند MNIST، را با قابلیت دانلود خودکار فراهم میکند.
- ماژول transforms مجموعهای از توابع آموزش پردازش تصویر دارد که تصاویر را به تنسور تبدیل میکنند (ToTensor) و مقادیر پیکسلها را پیش از ورود به شبکه عصبی نرمالسازی میکنند (Normalize).
آموزش ساخت یک شبکه عصبی ساده با PyTorch و Torchvision
با ترکیب مفاهیم گفتهشده، یک شبکه عصبی کامل برای تشخیص اعداد دستنویس از ۰ تا ۹ روی دیتاست معروف MNIST با استفاده از PyTorch و Torchvision میسازیم.
نصب پایتورچ و Torchvision
برای نصب نسخه CPU پایتورچ و کتابخانههای جانبی آن در سیستمعاملهای ویندوز، مک یا لینوکس، دستور زیر را در خط فرمان (Terminal) اجرا کنید:
pip install torch torchvision torchaudioاگر کد را در محیطهای تعاملی نوتبوک، مانند Jupyter Notebook یا Google Colab، مینویسید، یک علامت تعجب (!) به ابتدای دستور اضافه کنید:
!pip install torch torchvision torchaudioاگر از محیطهای توسعه یکپارچه (IDE) استفاده میکنید، با کمک راهنمای نصب و کار با پای چارم میتوانید این دستور را مستقیماً در ترمینال داخلی PyCharm اجرا کنید و پکیجها را مدیریت کنید.

بارگذاری و پیشپردازش دادهها با Torchvision
ابتدا پکیجهای مورد نیاز را فراخوانی میکنیم. سپس با transforms.Compose یک خط لوله پیشپردازش میسازیم که تصاویر MNIST را به تنسور تبدیل میکند و مقادیر آنها را با میانگین و انحراف معیار ۰.۵ نرمالسازی میکند. پس از آن، دادهها را با DataLoader در دستههای (Batch) ۶۴تایی قرار میدهیم تا در هر مرحله از آموزش، ۶۴ تصویر به صورت همزمان پردازش شوند.
import torch
from torchvision import datasets, transforms
# تعریف مراحل تبدیل تصویر به تنسور و نرمالسازی
transform = transforms.Compose([
transforms.ToTensor(),
transforms.Normalize((0.5,), (0.5,))
])
# دانلود و بارگذاری دادههای آموزشی MNIST
train_data = datasets.MNIST(root='./data', train=True, download=True, transform=transform)
train_loader = torch.utils.data.DataLoader(train_data, batch_size=64, shuffle=True)
# دانلود و بارگذاری دادههای تست برای ارزیابی نهایی
test_data = datasets.MNIST(root='./data', train=False, download=True, transform=transform)
test_loader = torch.utils.data.DataLoader(test_data, batch_size=64, shuffle=False)تعریف معماری مدل و تابع خطا
هر تصویر در دیتاست MNIST، ۲۸ در ۲۸ پیکسل است. برای مدل، کلاسی به نام MNISTModel با سه لایه خطی (nn.Linear) میسازیم. در متد forward، ابتدا تصویر دوبعدی را با view(-۱, ۲۸*۲۸) مسطح (Flatten) میکنیم و به یک بردار ۷۸۴تایی تبدیل میکنیم. لایه اول این ۷۸۴ ویژگی را به ۱۲۸ گره، لایه دوم به ۶۴ گره و لایه سوم به ۱۰ کلاس خروجی، معادل اعداد ۰ تا ۹، نگاشت میکند.
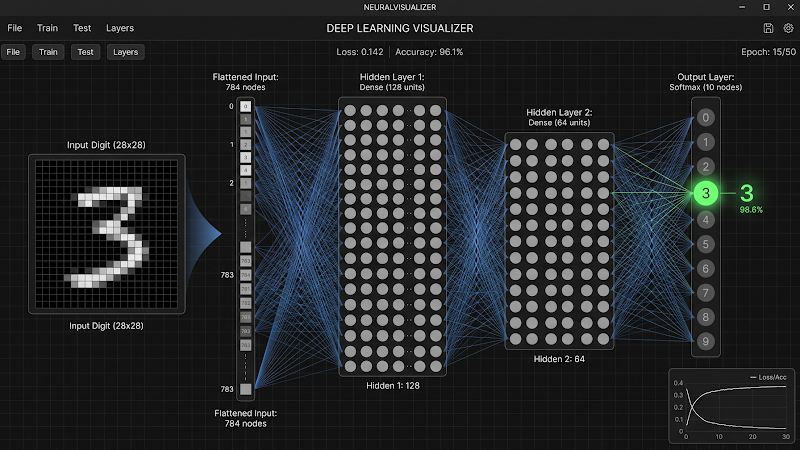
پس از نمونهسازی از مدل، باید معیار خطا (Loss Function) را مشخص کنیم. پایتورچ معیارهای متنوعی دارد؛ از جمله nn.MSELoss برای محاسبه میانگین مربعات خطا و nn.BCELoss برای دستهبندی دودویی (Binary Cross-Entropy). چون مسئله ما ۱۰ کلاس دارد، از nn.CrossEntropyLoss به عنوان تابع خطا و از الگوریتم optim.SGD به عنوان بهینهساز استفاده میکنیم.
import torch
import torch.nn as nn
import torch.optim as optim
class MNISTModel(nn.Module):
def __init__(self):
super(MNISTModel, self).__init__()
self.fc1 = nn.Linear(28 * 28, 128) # لایه اول: ورودی ۷۸۴ به ۱۲۸
self.fc2 = nn.Linear(128, 64) # لایه دوم: کاهش ابعاد به ۶۴
self.fc3 = nn.Linear(64, 10) # لایه سوم: خروجی ۱۰ کلاسی (اعداد ۰ تا ۹)
def forward(self, x):
x = x.view(-1, 28 * 28) # مسطح کردن تصویر به بردار ۷۸۴تایی
x = torch.relu(self.fc1(x)) # اعمال تابع فعالسازی ReLU روی لایه اول
x = torch.relu(self.fc2(x)) # اعمال ReLU روی لایه دوم
x = self.fc3(x) # خروجی نهایی
return x
model = MNISTModel()
# تعریف معیار خطا و بهینهساز
criterion = nn.CrossEntropyLoss()
optimizer = optim.SGD(model.parameters(), lr=0.01)حلقه آموزش (Training Loop) و ارزیابی مدل
فرآیند آموزش مدل در یک حلقه تکرار، در این پروژه با ۵ دور یا Epoch، انجام میشود. هر تکرار شامل ۵ گام است که به ترتیب اجرا میشوند:
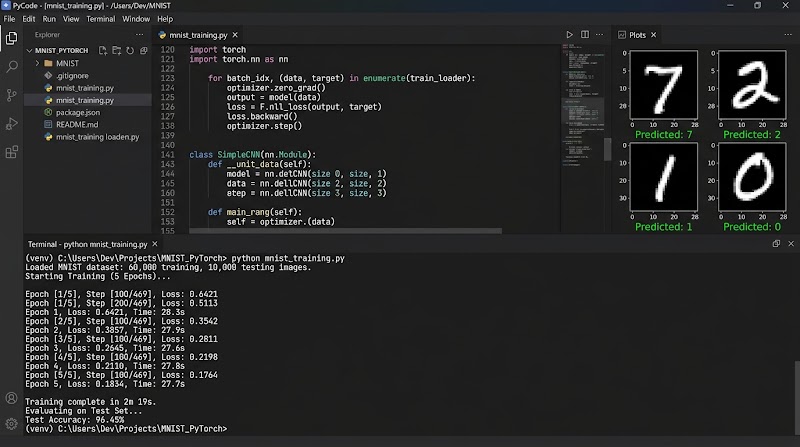
- ورودیها به مدل داده میشوند تا در مسیر رو به جلو (Forward Pass) پیشبینی اولیه تولید شود (model(inputs)).
- تابع خطا اختلاف بین پیشبینی مدل و برچسبهای واقعی را اندازهگیری میکند (criterion).
- پیش از اجرای مسیر رو به عقب، گرادیانهای مرحله قبل باید با optimizer.zero_grad() صفر شوند. در پایتورچ، فراخوانی .backward() به طور پیشفرض گرادیانهای جدید را با گرادیانهای قبلی جمع (تجمیع) میکند و مقادیر قبلی را بازنویسی نمیکند؛ به همین دلیل باید آنها را پاک کنیم.
- با انتشار رو به عقب (loss.backward())، مشتق خطا نسبت به تمام وزنهای شبکه محاسبه میشود.
- بهینهساز با optimizer.step() پارامترهای مدل را بر اساس گرادیانهای محاسبهشده اصلاح میکند و وزنها را بهروزرسانی میکند.
کد زیر مراحل بارگذاری دادههای آموزشی، تعریف مدل و اجرای حلقه آموزش را کنار هم قرار میدهد:
import torch
import torch.nn as nn
import torch.optim as optim
from torchvision import datasets, transforms
transform = transforms.Compose([
transforms.ToTensor(),
transforms.Normalize((0.5,), (0.5,))
])
train_data = datasets.MNIST(root='./data', train=True, download=True, transform=transform)
train_loader = torch.utils.data.DataLoader(train_data, batch_size=64, shuffle=True)
class MNISTModel(nn.Module):
def __init__(self):
super(MNISTModel, self).__init__()
self.fc1 = nn.Linear(28 * 28, 128)
self.fc2 = nn.Linear(128, 64)
self.fc3 = nn.Linear(64, 10)
def forward(self, x):
x = x.view(-1, 28 * 28)
x = torch.relu(self.fc1(x))
x = torch.relu(self.fc2(x))
x = self.fc3(x)
return x
model = MNISTModel()
criterion = nn.CrossEntropyLoss()
optimizer = optim.SGD(model.parameters(), lr=0.01)
# حلقه آموزش مدل در ۵ دور (Epoch)
for epoch in range(5):
for inputs, targets in train_loader:
outputs = model(inputs) # ۱. عبور دادهها از مدل
loss = criterion(outputs, targets) # ۲. محاسبه خطا
optimizer.zero_grad() # ۳. صفر کردن گرادیانهای انباشتهشده قبلی
loss.backward() # ۴. محاسبه گرادیانها در مسیر رو به عقب
optimizer.step() # ۵. بهروزرسانی وزنها
print(f'Epoch {epoch+1}, Loss: {loss.item():.4f}')پس از پایان آموزش، عملکرد مدل را روی دادههای تست بررسی میکنیم. برای این کار از بلوک with torch.no_grad(): استفاده میکنیم، زیرا در مرحله تست به بهروزرسانی وزنها و محاسبه گرادیان نیاز نداریم. کد کامل پروژه، از آموزش تا ارزیابی نهایی روی دادههای تست، به این صورت است:
import torch
import torch.nn as nn
import torch.optim as optim
from torchvision import datasets, transforms
transform = transforms.Compose([
transforms.ToTensor(),
transforms.Normalize((0.5,), (0.5,))
])
train_data = datasets.MNIST(root='./data', train=True, download=True, transform=transform)
train_loader = torch.utils.data.DataLoader(train_data, batch_size=64, shuffle=True)
test_data = datasets.MNIST(root='./data', train=False, download=True, transform=transform)
test_loader = torch.utils.data.DataLoader(test_data, batch_size=64, shuffle=False)
class MNISTModel(nn.Module):
def __init__(self):
super(MNISTModel, self).__init__()
self.fc1 = nn.Linear(28 * 28, 128)
self.fc2 = nn.Linear(128, 64)
self.fc3 = nn.Linear(64, 10)
def forward(self, x):
x = x.view(-1, 28 * 28)
x = torch.relu(self.fc1(x))
x = torch.relu(self.fc2(x))
x = self.fc3(x)
return x
model = MNISTModel()
criterion = nn.CrossEntropyLoss()
optimizer = optim.SGD(model.parameters(), lr=0.01)
for epoch in range(5):
for inputs, targets in train_loader:
outputs = model(inputs)
loss = criterion(outputs, targets)
optimizer.zero_grad()
loss.backward()
optimizer.step()
# ارزیابی دقت مدل روی دادههای تست
correct = 0
total = 0
with torch.no_grad():
for inputs, targets in test_loader:
outputs = model(inputs)
_, predicted = torch.max(outputs.data, 1) # انتخاب کلاسی که بیشترین احتمال را دارد
total += targets.size(0)
correct += (predicted == targets).sum().item()
print(f'Accuracy: {100 * correct / total:.2f}%')اگر پس از اجرای این پروژه قصد پیادهسازی معماریهای پیچیدهتر، مانند شبکههای پیچشی و بازگشتی، را دارید، گذراندن دورههای تخصصیتر مرحله بعدی یادگیری شما خواهد بود.

معایب و محدودیتهای پایتورچ
استفاده از پایتورچ، با وجود انعطافپذیری بالا در محیطهای تحقیقاتی، چالشها و محدودیتهایی دارد که پیش از انتخاب آن برای پروژههای سازمانی باید در نظر گرفته شوند:
- پایتورچ در مقایسه با رقیب اصلی خود یعنی TensorFlow، ابزارهای جانبی کمتری برای استقرار (Deployment) مستقیم و مانیتورینگ مدلها در محیطهای تولیدی (Production) و مقیاسهای صنعتی بزرگ دارد. آمادهسازی مدل برای محیط عملیاتی ممکن است به کار بیشتری نیاز داشته باشد.
- نصب نسخه CPU ساده است، اما راهاندازی اولیه با GPU میتواند برای مبتدیان دشوار باشد. پیکربندی صحیح درایورها و تطبیق نسخههای CUDA برای اجرای بدون خطای پایتورچ روی کارت گرافیک میتواند کاربران تازهکار را با مشکل روبهرو کند.
- تمرکز اصلی PyTorch بر زبان پایتون و مجموعه ابزارهای هوش مصنوعی با پایتون است. در مقایسه با فریمورکهایی که APIهای گستردهای برای زبانهای مختلف دارند، این تمرکز برای تیمهایی که قصد پیادهسازی مستقیم در زبانهای دیگر را دارند محدودیت ایجاد میکند.
مقایسه PyTorch و TensorFlow؛ کدام را انتخاب کنیم؟
تنسورفلو (TensorFlow) که گوگل آن را توسعه داده است، مهمترین رقیب پایتورچ در یادگیری عمیق است. در نسخههای اولیه، تفاوت اصلی این دو در نحوه تعریف گراف محاسباتی بود. از نسخه TensorFlow ۲.۰ به بعد، قابلیت اجرای پویا (Eager Execution) به صورت پیشفرض به تنسورفلو نیز اضافه شد. جدول زیر تفاوتهای فنی و کاربردی دو فریمورک را نشان میدهد:
| ویژگی | PyTorch | TensorFlow |
|---|---|---|
| گراف محاسباتی | پویا (Dynamic / Define-by-run) | پویا (Eager Execution به صورت پیشفرض از نسخه ۲.۰) |
| زبانهای برنامهنویسی | تمرکز اصلی بر پایتون | پایتون، C++، JavaScript |
| سادگی کدنویسی و دیباگ | ساختار پایتونیک، خوانا و خطایابی آسان | منحنی یادگیری شیبدارتر و نسبتاً پیچیدهتر |
| ابزارهای استقرار (Deployment) | TorchScript و ONNX | TensorFlow Serving و TensorFlow Lite |
| محبوبیت و حوزه تمرکز | بسیار محبوب در پژوهش و نمونهسازی سریع | استفاده گسترده در پژوهش، اما قویتر در محیطهای تولیدی (Production) و مقیاس بزرگ |
راهنمای انتخاب:
اگر هدفتان یادگیری مفاهیم شبکه عصبی، انجام پروژههای دانشگاهی، پیادهسازی مقالات جدید هوش مصنوعی یا نمونهسازی سریع است و میخواهید کدهایی خوانا و نزدیک به ساختار استاندارد پایتون بنویسید، PyTorch انتخاب مناسبتری برای شماست. اگر در تیمی کار میکنید که استقرار مدلها در مقیاس صنعتی بزرگ، استفاده از ابزارهای مانیتورینگ پیشرفته یا اجرای مدل روی بسترهای متنوع به زبانهای جاوااسکریپت و برنامهنویسی C++ را در اولویت دارد، TensorFlow ابزارهای آمادهتری در اختیارتان قرار میدهد.
برای یادگیری ساختاریافته و پروژهمحور این فریمورک، میتوانید در دورههای آموزشی شرکت کنید و مدلهای هوش مصنوعی خود را پیادهسازی کنید.